Étude 14 / 14 · Football · données · modèle · Coupe du monde 2026
IAFoot : 46 résultats justes sur 74 matchs, et 6 scores exacts.
Soixante-quatorze matchs de Coupe du monde, pronostiqués avant le coup d'envoi et archivés. Le résultat est juste quarante-six fois, le score exact six fois. Le modèle estime les buts attendus de chaque équipe, puis les convertit en distribution. Aucun modèle de langage ne décide ici, et c'est pour cela que le projet ne s'appelle plus footllm.
Le nom promettait un modèle de langage. Le modèle compte des buts.
Le projet s'appelait footllm. Le nom laissait entendre un modèle de langage lisant des comptes rendus avant de répondre en mots. Ce n'est pas ce qui se passe. Un réseau de neurones prend les données d'avant-match, estime deux valeurs de buts attendus, une par équipe, et les convertit en une table de probabilités de scores. Tout ce qui est publié ici sort de cette table : le résultat le plus probable, le score le plus probable, et la probabilité de plus de deux buts et demi.
Un modèle de langage a été testé sur les mêmes données, dans une autre branche du projet. Il n'a pas été gardé dans la boucle de décision : quand ce sont les nombres qui comptent, le réseau qui traite les flottants directement fait mieux qu'un modèle qui les lit comme du texte. Appeler l'ensemble footllm promettait donc autre chose que ce que le pipeline fait, et un lecteur pouvait croire qu'un agent conversationnel devinait les scores. IAFoot dit ce que c'est : un modèle de football qui estime les buts, évalué sur des matchs qu'il n'avait jamais vus.
Soixante-quatorze matchs, et des pronostics écrits avant.
Le corpus est le forward-test du projet : chaque match de la Coupe du monde 2026 pour lequel un fichier de pronostic a été archivé avant le coup d'envoi, puis joué. Six archives couvrent le tournoi, du premier match de groupe le 11 juin au dernier match relevé le 15 juillet, sur 28 journées. Chaque ligne contient les deux équipes, le score réel, le résultat prédit, le score prédit, et trois drapeaux : résultat juste, score exact, score parmi les trois plus probables.
Rien n'a été ajouté après coup. Un match sans pronostic archivé n'entre pas dans le compte, même quand le modèle aurait eu raison. Le fichier fait 74 lignes, il est publié à côté du notebook, et chaque chiffre de cette page est recalculé à partir de lui.
Cinq règles, dont une qui explique tout l'écart.
- Le modèle estime les buts attendus de chaque équipe à partir des données d'avant-match : forme, notes, avantage du terrain, force de l'adversaire.
- Ces deux valeurs alimentent une loi de Poisson, et la table des scores est le produit des deux. Rien d'autre n'est simulé.
- Le résultat prédit est le côté de la table qui porte le plus de probabilité. Le score prédit est la case la plus probable, prise seule.
- Les pronostics ont été archivés avant le coup d'envoi et jamais réécrits pendant le tournoi. Le modèle n'a pas été réentraîné entre deux tours.
- Le compte couvre tous les matchs archivés, pas une sélection. Aucun match n'est retiré parce que son pronostic est mauvais.
Un résultat juste deux fois sur trois. Un score exact une fois sur douze.
Sur 74 matchs, le résultat prédit correspond à la réalité 46 fois, soit 62,2 %. Le score exact tombe six fois, 8,1 %. Le score réel figure parmi les trois scores les plus probables 23 fois, 31,1 %. Ces trois chiffres décrivent le même modèle à trois niveaux de précision, et ils disent la chose évidente : ce modèle sait quel camp est le plus fort, pas quel score sortira.
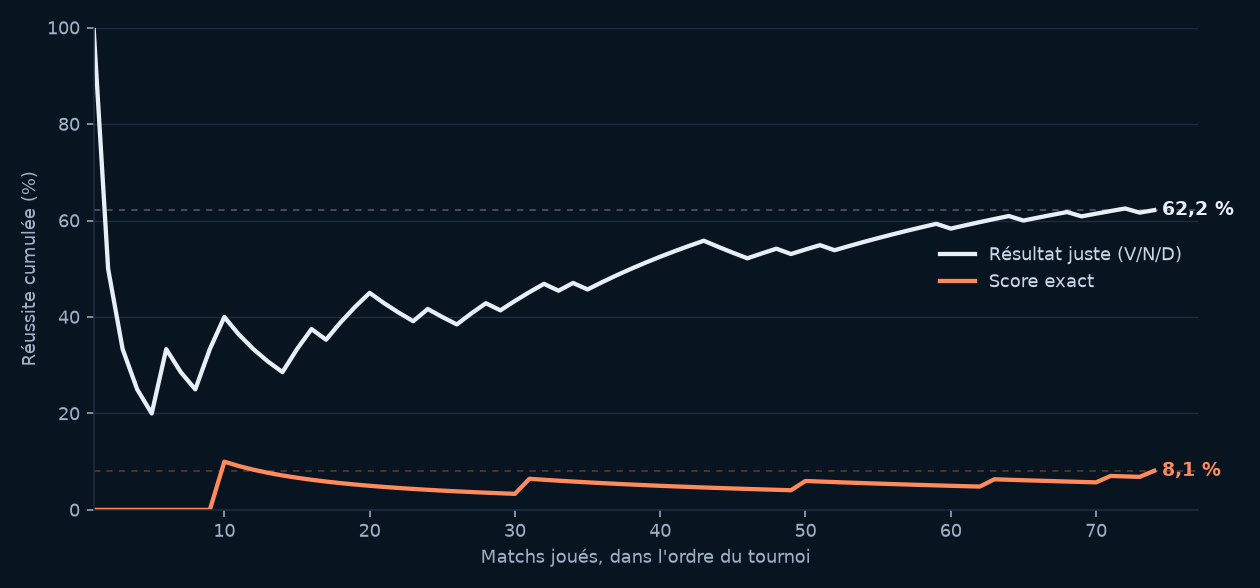
L'écart entre 62,2 % et 8,1 % n'est pas un défaut du modèle, c'est la forme du football. Le score le plus probable est presque toujours un petit score, 1-0 ou 2-0, parce que la distribution s'y entasse. Sur ce tournoi, le score le plus probable totalisait 1,41 but de moins que la réalité par match, et il est resté sous le total réel dans 48 des 74 matchs. Le tournoi a marqué 238 buts en 74 rencontres, plus de trois par match : un mode ne peut pas suivre cela.
La même table donne les marchés de buts, et là elle tient mieux. 46 des 74 matchs ont dépassé deux buts et demi, 62,2 %, et les deux équipes ont marqué dans 42 d'entre eux, 56,8 %. Un modèle construit pour estimer des buts est plus à l'aise là que sur le score exact, et c'est là qu'il faut le lire.
Soixante-quatorze matchs, c'est un tournoi, pas une loi.
- Que le modèle soit calibré : les archives de pronostics contiennent des probabilités, le corpus de rejeu non. Aucun score de Brier et aucune comparaison aux cotes ne sont publiés ici, parce qu'aucun des deux ne se recalcule à partir des 74 lignes.
- Que ces 62,2 % se répètent : sur 74 matchs, l'intervalle à 95 % fait environ onze points de large, donc le niveau réel peut se situer entre 51 % et 73 %.
- Que le modèle ait vu un tournoi normal : cette Coupe du monde a marqué 3,2 buts par match, plus que la moyenne historique, ce qui pénalise un modèle entraîné sur des rencontres plus anciennes et plus fermées.
- Que le score exact soit une prévision : c'est la case la plus probable d'une distribution, pas le nombre de buts attendu. Confondre les deux, c'est précisément la façon dont un modèle se met à mentir sans qu'on change une ligne de code.
Changer le nom, garder les chiffres.
J'ai renommé le projet IAFoot. Pas pour cacher le travail sur le modèle de langage, qui existe et qui est documenté, mais parce qu'un nom est une promesse : footllm promettait que les mots décident, alors que le code qui produit ces 74 lignes est un modèle de buts. Un lecteur venu pour un agent conversationnel aurait trouvé une table de Poisson, et il aurait eu raison de se sentir trompé.
Je publie les 74 lignes, les six scores exacts compris. Un forward-test ne vaut que si les mauvais matchs restent dedans. Les fois où le modèle a annoncé un score qui n'est jamais venu font partie du résultat, exactement comme les six qui sont tombés juste.
Ce qui reste : un modèle qui nomme le camp le plus fort deux fois sur trois, rate le score onze fois sur douze, et un projet dont le nom correspond enfin à son code.
Sur les données Un corpus figé : 74 lignes du forward-test du projet, écrites avant le coup d'envoi, couvrant 28 journées du 11 juin au 15 juillet 2026. Aucune ligne ajoutée, aucune retirée, aucun pronostic réécrit.
Notebook rejoué : 7 assertions sur 74 matchs · 1 corpus figé · rejoué le 6 novembre 2026 · la page des preuves