Étude 01 / 11 · Football analytics · Projet personnel
J'ai testé 83 façons de noter un joueur. 55 tiennent.
Six saisons, trois sources, 33 168 matchs. Ce que ça change pour une table de scouting, et ce que ça laisse de côté.
Un tableau de bord n'est pas un classement.
Une table de scouting ressemble à un tableau de bord : vingt colonnes, un tri, des couleurs. Le problème n'est pas la quantité. Le problème, c'est que personne ne demande à ces colonnes si elles mesurent quelque chose de stable.
J'ai posé la question à 83 dimensions, sur six saisons. La réponse est désagréable : une sur trois ne tient pas une saison de titulaire. Autrement dit, un tiers des dimensions testées ne départage personne.
Ce n'est pas un détail de méthode. Une colonne qui ne classe rien produit un classement qui ne classe personne. Derrière, il y a une décision de recrutement prise sur un tri qui n'a pas de sens.
D'abord réconcilier les identités.
Six saisons au total, cinq complètes et la saison en cours. Trois sources : SofaScore, WhoScored, Transfermarkt. 33 168 matchs distincts, dont 31 345 couverts par le flux d'événements Opta, 1 822 dont on ne connaît que le résultat, et un indexé sans flux.
Le travail commence avant le modèle : un même joueur porte trois identifiants, parfois deux orthographes, et les clubs changent de nom en cours de saison. Sans cette étape, on compare des joueurs qui n'existent pas.
Deuxième décision de périmètre : séparer les clubs des sélections. Un international ne joue pas dans le même contexte, avec les mêmes coéquipiers ni le même temps de jeu. Mélanger les deux, c'est fabriquer de la variance et l'appeler talent.
Ce ne sont pas des flux licenciés. SofaScore, WhoScored et Transfermarkt sont des sources grand public, collectées côté web. La limite est structurelle : elle porte sur des événements et des notes publiques, pas sur du tracking. Un club qui travaille sur des flux licenciés devra refaire le test sur ses propres définitions. La méthode, elle, se transporte.
Cinq étapes, dont une qui tranche.
- Réconcilier les identités entre les trois sources.
- Figer la définition de chaque dimension avant de mesurer.
- Tester chaque dimension sur une saison de titulaire, avec assez de minutes pour que la mesure ait un sens.
- Ne retenir une mesure que si un titulaire (30 matchs-équivalents) atteint 0,70 de fiabilité, et si aucun moyennage de saisons ne la rattrape.
- Écarter et documenter ce qui échoue, sans le garder « au cas où ».
Le critère qui compte est le quatrième. La cible est 0,70, projetée sur une saison de titulaire ; par match, l'échelle où le tableau publie ses chiffres, le seuil retenu est 0,083 (la meilleure des écartées : 0,070). En dessous, l'écart observé entre deux joueurs reste compatible avec la variance de mesure. Et cette cible ne s'achète pas en empilant les saisons. Sur les 28 mesures écartées, aucune n'atteint 0,70 en moyennant deux saisons, la meilleure plafonne à 0,66. Le test ne demande pas si la colonne est intéressante. Il demande si elle dit la même chose d'un match à l'autre, et d'une saison à l'autre.
83 testées, 55 tiennent, 28 documentées comme écartées.
Les 28 qui tombent ne disparaissent pas : elles sont documentées. C'est la partie du travail que personne ne publie, et c'est celle qui évite de refaire l'erreur l'année suivante.
Le chiffre qui fait mal, c'est celui des 20 colonnes qu'une table de scouting propose par défaut. 10 seulement tiennent une saison de titulaire : une chez les gardiens, trois chez les défenseurs, quatre chez les milieux, deux chez les attaquants. Neuf tombent. La vingtième, un cumul de buts évités, n'est même pas amortissable, donc elle n'est jamais classée. Et la note, seule colonne proposée aux quatre postes, tombe avec les autres (0,070). En cours de saison, c'est pire. À 6,7 matchs-équivalents de profondeur médiane, un audit de septembre en trouvait 16 sur 20 qui ne départageaient personne.
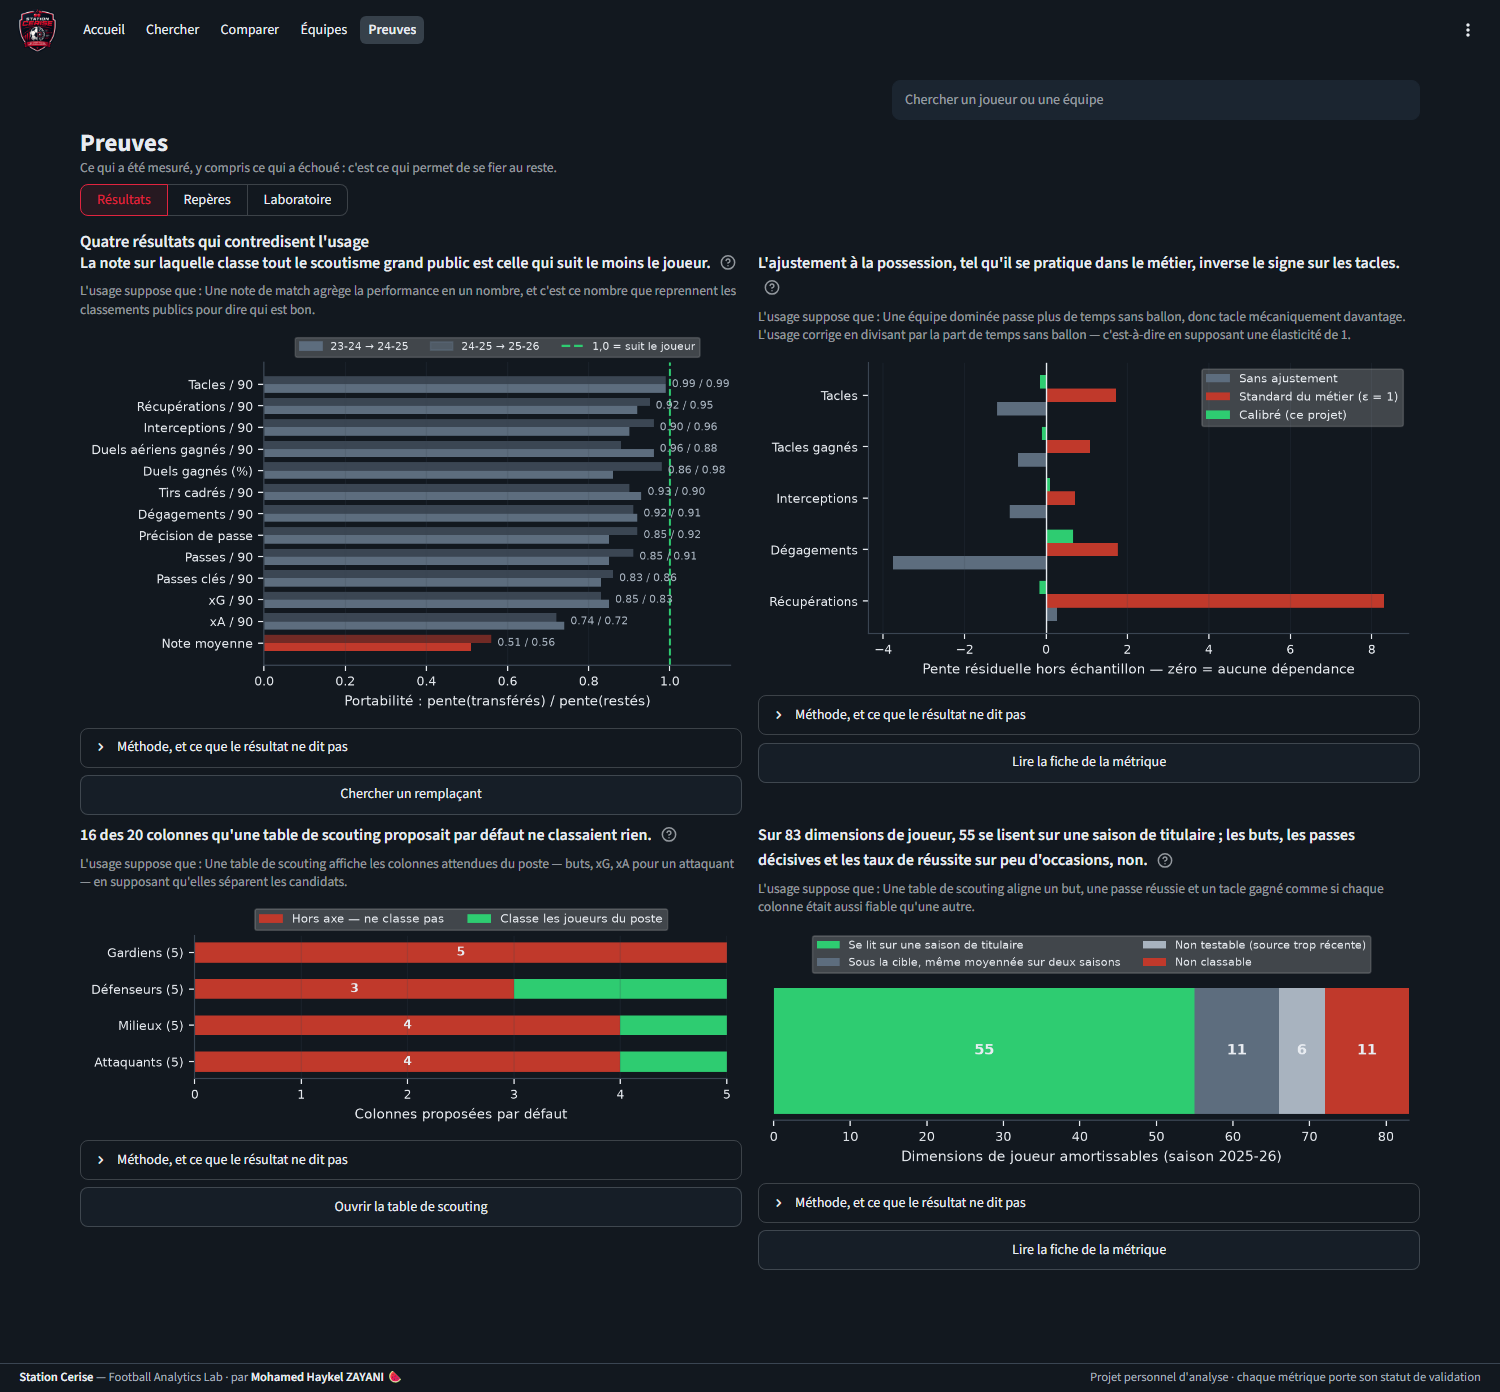
Trois exemples de ce sur quoi il ne faut pas classer : les buts et les passes décisives, qui restent sous la cible même moyennés sur deux saisons (0,56 et 0,48), et les taux de réussite calculés sur trop peu d'occasions, dont la fiabilité s'effondre (0,00 à 0,05). Ce ne sont pas des mesures inutiles. Elles sont instables à l'échelle d'une saison de titulaire, et un classement qui les met en tête de gondole prétend plus qu'il ne sait.
Stable n'est pas juste.
- Que les 55 mesures restantes soient les bonnes. Elles sont stables ; ce n'est pas la même chose qu'être justes.
- Que le résultat tienne hors de ce corpus : six saisons, trois sources, un périmètre.
- Que les buts et les passes décisives ne valent rien : ils valent quelque chose, mais pas ce qu'un classement prétend en dire.
- Qu'une mesure stable soit pertinente : elle peut mesurer un détail avec une constance parfaite.
Ce que je livrerais dans un club.
Je ne livre pas vingt colonnes. J'en livre cinq, choisies pour ce qu'elles départagent à ce poste, avec l'intervalle affiché à côté du chiffre.
Je refuse de classer un joueur sur une saison partielle, et je sépare club et sélection en deux vues distinctes.
Si une colonne ne classe rien, elle sort du tableau, même si elle rassure.
La conséquence est inconfortable : un livrable plus court, plus lent à produire, et discutable en réunion. C'est le prix d'un classement qu'on peut défendre quand on vous demande d'où il sort.
Notebook : chaque chiffre publié est asserté · 83 dimensions, les 55 retenues et les 20 colonnes par défaut recomptées depuis la table de fiabilité (10 tiennent, 9 tombent, une n'est jamais classée) · rejoué le 2 novembre 2026 · la page des preuves